O número mais alto raramente é o mais confiável: uma bateria de testes de falsificação para alegações de aprendizado de máquina em saúde
Estudo transversal pré-registrado em três modalidades
Leandro Souza Anselmo — Medicina, Pedro Juan Caballero, Paraguai
Resumo
Contexto. Alegações de desempenho em aprendizado de máquina aplicado à saúde são publicadas majoritariamente com métricas de discriminação obtidas na mesma fonte de dados em que o modelo foi treinado. Vazamento entre partições, aprendizado de atalho e extrapolação para fora do domínio de aplicabilidade são reconhecidos como ameaças, mas raramente são testados de forma explícita — e quase nunca se publica o teste que teria derrubado o próprio resultado.
Objetivo. Avaliar se uma bateria mínima e portátil de testes de falsificação, aplicável em CPU e sem retreinar modelos, distingue resultados confiáveis de resultados aparentemente fortes em três modalidades distintas.
Métodos. Estudo transversal com pré-registro escrito antes da execução, abrangendo três projetos independentes: predição de atividade antibacteriana contra Staphylococcus aureus (46001 moléculas), classificação de tuberculose e pneumonia em radiografia de tórax (800 e 5856 imagens) e predição de sepse em terapia intensiva (40.336 pacientes, 1.552.210 horas). A bateria compreende: validação externa por fonte nos dois sentidos; oclusão anatômica; verificação de composição da lista de candidatos com teto de similaridade; PR-AUC interpretada contra a prevalência; e comparação pareada entre alternativas com intervalo de confiança por reamostragem da unidade de observação.
Resultados. Em cada um dos três projetos, o maior número de desempenho e o resultado mais confiável não coincidiram. A classificação de pneumonia atingiu ROC-AUC 0,9946 ± 0,0023 e manteve 0,8305 com o campo pulmonar ocluído, indicando atalho. A triagem molecular produziu 17 candidatos aprovados nos três critérios pré-declarados, dos quais 11 de 17 pertencem a classes antibióticas conhecidas, com Tanimoto mediano de 0,832 ao conjunto de treino. A predição de sepse atingiu ROC-AUC 0,8450 com PR-AUC 0,1137 sobre prevalência horária de 1,80%, e não emitiu alerta algum para 691 de 2932 pacientes sépticos. A classificação de tuberculose funcionou como controle positivo: ROC-AUC intra-fonte 0,9078 ± 0,0356, queda para 0,6566 sob oclusão e média de 0,8145 em validação externa.
Conclusão. A bateria identificou como frágeis dois resultados que pareceriam publicáveis pelas métricas convencionais e preservou um terceiro. O custo computacional é desprezível frente ao do treinamento. Propomos que testes de falsificação, com relato obrigatório dos que falham, integrem o requisito mínimo de alegações de desempenho em saúde.
Palavras-chave: aprendizado de máquina; reprodutibilidade; validação externa; aprendizado de atalho; domínio de aplicabilidade; pré-registro.
1. Introdução
A literatura de aprendizado de máquina em saúde cresce mais rápido do que a capacidade de replicá-la. Revisões sistemáticas têm apontado que a maioria dos modelos publicados relata apenas métricas de discriminação obtidas por validação cruzada na mesma fonte de dados usada no treinamento, sem avaliação em fonte independente e sem exame das razões pelas quais o modelo acerta.
Três ameaças são especialmente frequentes. O vazamento ocorre quando informação do conjunto de teste influencia o treinamento — por partição que separa imagens em vez de pacientes, por análogos quase idênticos distribuídos entre as partições, ou por decisões de pré-processamento tomadas sobre o conjunto completo. O aprendizado de atalho ocorre quando o modelo encontra um sinal correlacionado ao desfecho porém irrelevante para ele, como marcações de equipamento ou características de aquisição. A extrapolação para fora do domínio de aplicabilidade ocorre quando a predição é emitida para observações dissimilares de tudo que o modelo viu.
Essas ameaças são bem descritas; o que falta é prática de rotina para testá-las. Duas lacunas nos parecem centrais. A primeira é a ausência de testes de derrubada — procedimentos desenhados para invalidar a própria alegação, cujo resultado é publicado independentemente de confirmar ou refutar. A segunda é a ausência de controle positivo: quando uma bateria de verificação reprova todos os casos examinados, não é possível distinguir entre um campo frágil e uma bateria excessivamente severa.
Este trabalho aplica uma bateria mínima a três projetos conduzidos em paralelo, em modalidades distintas — moléculas, imagem e série temporal clínica —, com pré-registro escrito antes da execução. A tese que emerge é única e verificável: em todos os três, o maior número de desempenho e o resultado mais confiável não coincidiram. A contribuição pretendida não é o catálogo de erros, e sim a bateria como instrumento reutilizável.
2. Métodos
2.1 Pré-registro e registro de desvios
As frentes de análise dos três projetos foram declaradas por escrito antes da execução, incluindo as métricas, as regras de partição e a regra de parada. O documento de pré-registro foi mantido sob controle de versão e as alterações posteriores foram acrescentadas como emendas datadas, preservando o texto original.
O relato de desvios é parte do resultado. Registramos seis itens pré-declarados que não foram executados (com a justificativa de cada um, predominantemente limite de disco ou de credenciamento de acesso), três itens executados de forma diferente da declarada, e cinco falhas de código que exigiram correção e reexecução. As três categorias são mantidas separadas de propósito: uma análise que não rodou por limite físico, uma que rodou de forma diferente e uma que quebrou e foi corrigida têm implicações distintas para a leitura dos resultados.
2.2 P1 — atividade antibacteriana (moléculas)
Conjunto derivado do ChEMBL, restrito a medidas de concentração inibitória mínima (MIC) contra S. aureus. O rótulo binário foi definido como ativo para MIC <= 4 ug/mL e inativo para MIC >= 16 ug/mL, exigindo no mínimo 2 medidas independentes por molécula e descartando a faixa intermediária. A escolha não é arbitrária: MIC é medida em diluições sucessivas por fator dois, e o valor 8 µg/mL é modal na distribuição, de modo que um corte posicionado exatamente nele classificaria como ativa uma grande massa de moléculas limítrofes. O conjunto final reúne 46001 moléculas.
Dez frentes de análise foram pré-declaradas, variando dado, representação e enquadramento do problema, e todas foram avaliadas com a mesma partição: cinco dobras agrupadas por arcabouço de Murcko. A partição aleatória foi calculada apenas como medida do vazamento — a diferença entre as duas — e nunca reportada como resultado.
2.3 P2 — tuberculose e pneumonia (imagem)
Radiografias de tórax de três fontes públicas: dois conjuntos de tuberculose (Montgomery e Shenzhen, 800 imagens somadas) e um conjunto de pneumonia pediátrica (5856 imagens). Partição por paciente em todos os casos. O ponto de partida principal foram pesos pré-treinados em radiografia de tórax; um segundo ponto de partida, pré-treinado em ImageNet, foi declarado antes da execução como comparação.
2.4 P3 — sepse em terapia intensiva (série temporal)
Desafio público de sepse com 40.336 pacientes e 1.552.210 horas de internação, 127 variáveis derivadas. A predição é estritamente causal: cada linha horária utiliza apenas informação disponível até aquela hora, verificado empiricamente pela recomputação da linha após remoção de todo o futuro. Comparamos um modelo de gradient boosting com uma rede recorrente.
2.5 A bateria de testes de falsificação
Cinco procedimentos, todos executáveis em CPU e sem retreinar modelos, exceto onde indicado:
- Validação externa por fonte, nos dois sentidos. Treinar em cada fonte e testar na outra, reportando ambos. Um único sentido é selecionável: a magnitude da queda depende de qual fonte serviu de treino.
- Oclusão anatômica. Aplicar o modelo já treinado a imagens com a região anatomicamente relevante suprimida. Desempenho preservado indica sinal externo à região de interesse.
- Composição da lista de candidatos com teto de similaridade. Verificar, para cada candidato aprovado, a similaridade ao conjunto de treino e a classe química a que pertence. Um critério de domínio com piso mas sem teto útil admite análogos quase idênticos.
- PR-AUC interpretada contra a prevalência. Em desfechos raros, ROC-AUC elevada é compatível com utilidade clínica baixa; a referência para PR-AUC é a prevalência, não 0,5.
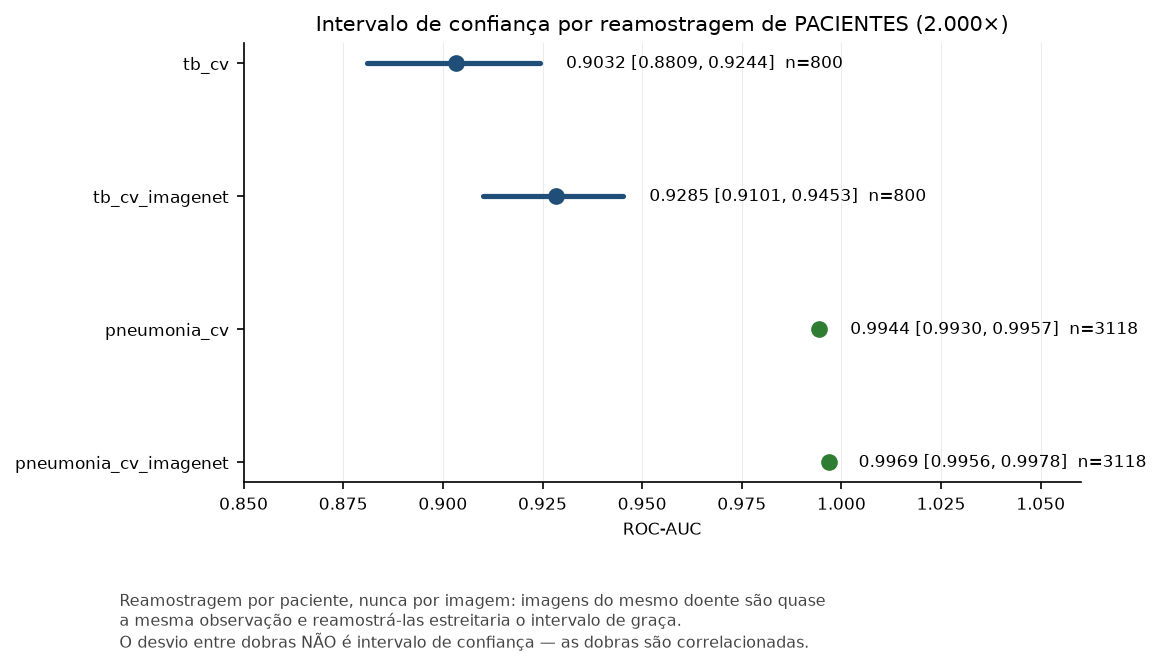
- Comparação pareada com intervalo de confiança por reamostragem da unidade de observação. Reamostrar pacientes, não imagens ou horas. O desvio entre dobras não é intervalo de confiança: as dobras são correlacionadas.
3. Resultados
3.1 P1 — positivo pela régua, redescoberta pelo conteúdo
As dez frentes produziram desempenho semelhante entre si (Tabela 1). O melhor resultado foi obtido por Fingerprints alternativos (ROC-AUC 0,8965); o baseline de similaridade de Tanimoto, que não envolve modelo algum, atingiu 0,8296 — diferença de 0,067. Representações aprendidas ficaram abaixo dos descritores convencionais: embeddings de transformador atingiram 0,8520 e a rede sobre grafo molecular 0,8762.
Tabela 1. Desempenho das dez frentes pré-declaradas do P1. Partição por arcabouço de Murcko, cinco dobras, em todas.
| # | Frente | ROC-AUC ± dp | PR-AUC ± dp |
|---|---|---|---|
| 1 | ChEMBL com rótulos limpos | 0,8948 ± 0,0067 | 0,8985 ± 0,0089 |
| 2 | CO-ADD (produtos naturais) | 0,8840 ± 0,0296 | 0,2432 ± 0,0531 |
| 3 | ChEMBL ampliado (outras unidades, MRSA) | 0,8891 ± 0,0077 | 0,8967 ± 0,0035 |
| 4 | Transfer learning antibacteriano | 0,8832 ± 0,0105 | 0,8887 ± 0,0106 |
| 5 | D-MPNN (chemprop) | 0,8762 ± 0,0099 | 0,8767 ± 0,0145 |
| 6 | Fingerprints alternativos | 0,8965 ± 0,0055 | 0,9003 ± 0,0083 |
| 7 | Embeddings ChemBERTa | 0,8520 ± 0,0114 | 0,8623 ± 0,0146 |
| 8 | Regressão de pMIC | 0,8730 | 0,8785 |
| 9 | Similaridade de Tanimoto (baseline) | 0,8296 ± 0,0087 | 0,8044 ± 0,0155 |
| 10 | Triagem restrita ao domínio (COCONUT) | — | — |
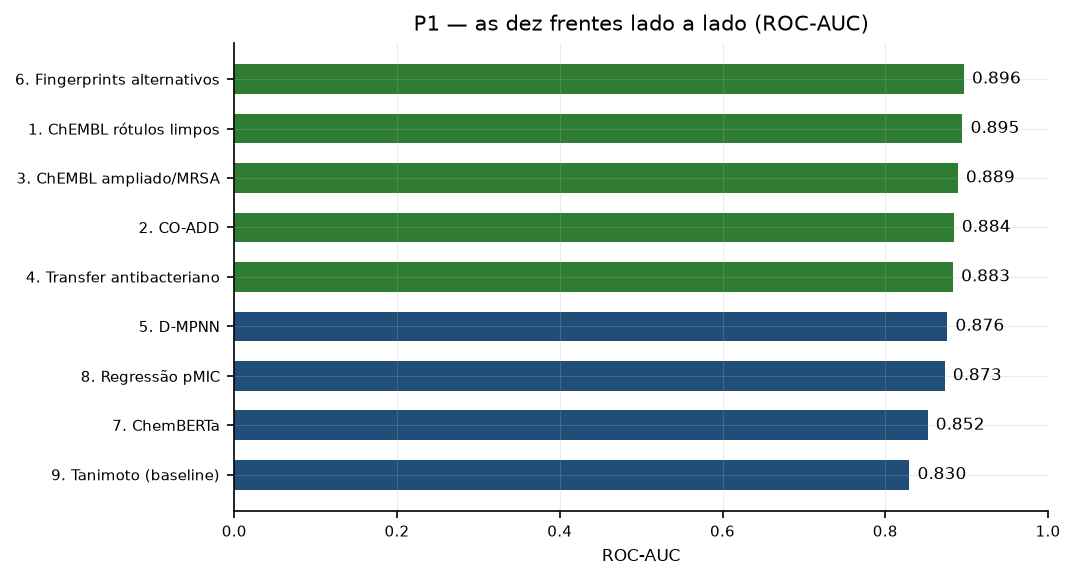
A triagem de biblioteca de produtos naturais aplicou o filtro final pré-declarado, composto por três critérios simultâneos. O funil reduziu a biblioteca a 57 candidatos após escore e domínio; a aplicação do terceiro critério — arcabouço inédito em relação ao treino — reduziu a 17.
Pela regra declarada antes da execução, a existência de candidatos aprovados caracteriza resultado positivo. O exame da composição da lista, contudo, mostra outra coisa: 11 dos 17 candidatos pertencem a classes antibióticas conhecidas (macrolídeos, tiopeptídeos e aminoglicosídeo), a massa molecular varia de 479,5 a 1648,9 Da e o Tanimoto ao conjunto de treino tem mediana 0,832, chegando a 0,975 (Tabela 2).
Tabela 2. Composição da lista de candidatos aprovados nos três critérios.
| Probabilidade | Tanimoto ao treino | Massa (Da) | Classe reconhecida |
|---|---|---|---|
| 0,9754 | 0,747 | 522,6 | tiazol (tiopeptideo) |
| 0,9613 | 0,857 | 835,0 | - |
| 0,9506 | 0,76 | 479,5 | tiazol (tiopeptideo) |
| 0,9473 | 0,975 | 580,8 | aminoglicosideo |
| 0,9309 | 0,901 | 1599,9 | macrolideo (lactona 12+);tiazol (tiopeptideo) |
| 0,9277 | 0,905 | 1368,6 | macrolideo (lactona 12+);tiazol (tiopeptideo) |
| 0,9263 | 0,878 | 922,1 | macrolideo (lactona 12+) |
| 0,9232 | 0,697 | 914,0 | - |
| 0,9224 | 0,839 | 564,4 | - |
| 0,9178 | 0,832 | 816,0 | macrolideo (lactona 12+) |
| 0,9178 | 0,832 | 816,0 | macrolideo (lactona 12+) |
| 0,9154 | 0,784 | 830,0 | macrolideo (lactona 12+) |
| 0,9062 | 0,783 | 886,0 | - |
| 0,9061 | 0,909 | 1648,9 | macrolideo (lactona 12+);tiazol (tiopeptideo) |
| 0,9048 | 0,761 | 842,0 | macrolideo (lactona 12+) |
| 0,9036 | 0,697 | 980,6 | - |
| 0,9017 | 0,863 | 562,8 | - |
A causa é identificável e corrigível: o critério de domínio de aplicabilidade possuía piso de similaridade, para excluir extrapolação, mas o teto estava posicionado em Tanimoto igual a 1,0 — isto é, apenas moléculas idênticas eram excluídas. Análogos próximos passam. Adicionalmente, o arcabouço de Murcko é descritor grosseiro para macrociclos: alteração pequena no anel gera arcabouço formalmente inédito com a molécula praticamente inalterada. O resultado é reportado com as duas leituras porque ambas são verdadeiras.
3.2 P2 — um atalho detectado e um controle positivo preservado
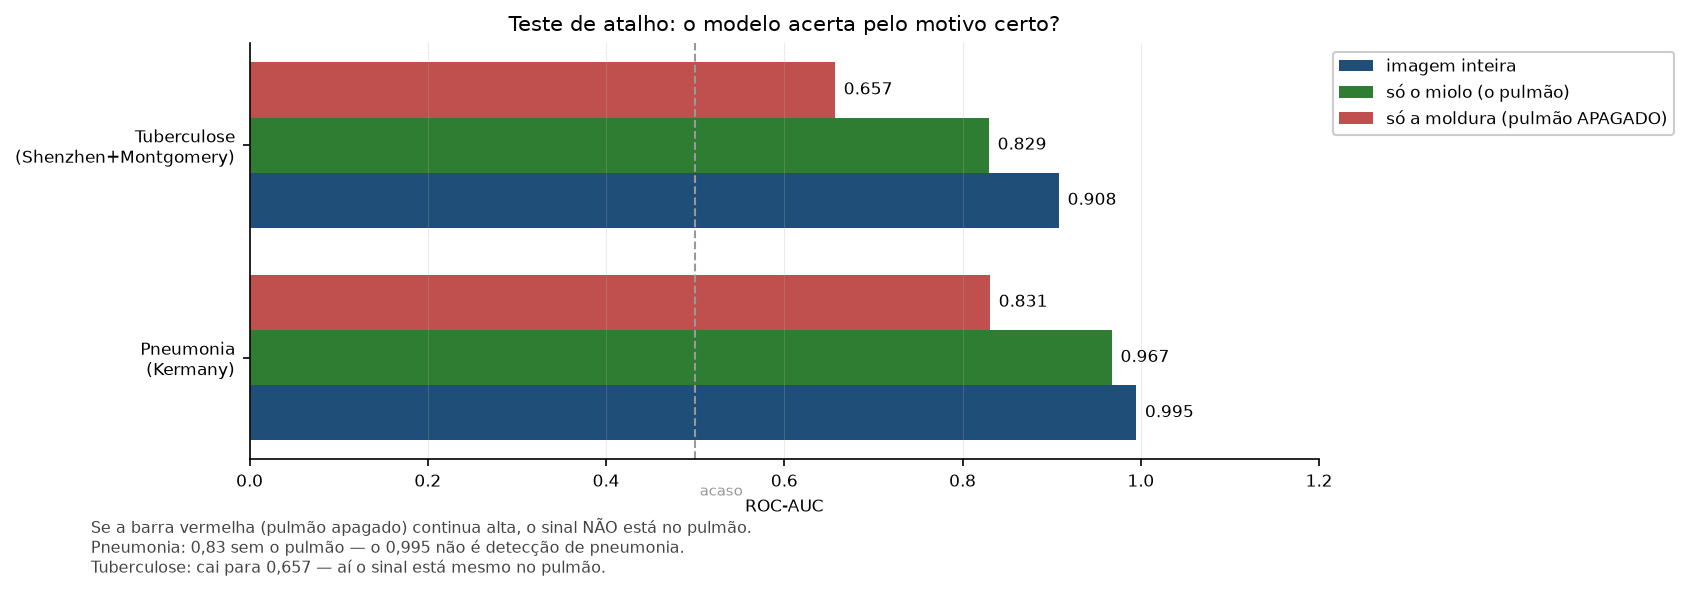
A classificação de pneumonia atingiu ROC-AUC 0,9946 ± 0,0023 sobre 5856 imagens. Sob oclusão do campo pulmonar central, preservando apenas a moldura da imagem, o desempenho manteve-se em 0,8305. A informação que sustenta o resultado não está, em proporção relevante, no pulmão.
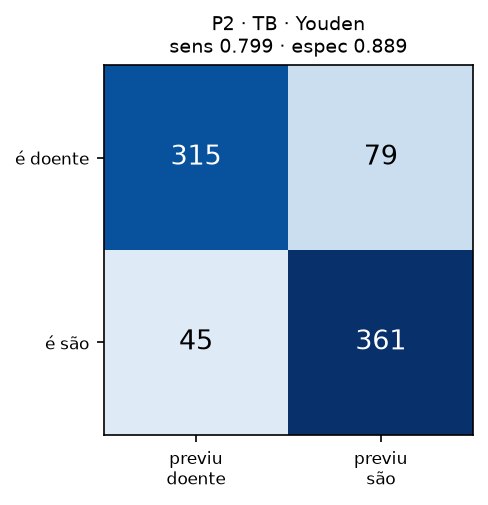
A classificação de tuberculose comportou-se de modo oposto: ROC-AUC 0,9078 ± 0,0356 intra-fonte, caindo para 0,6566 sob a mesma oclusão. Sensibilidade e especificidade no ponto de Youden foram 0,799 e 0,889.
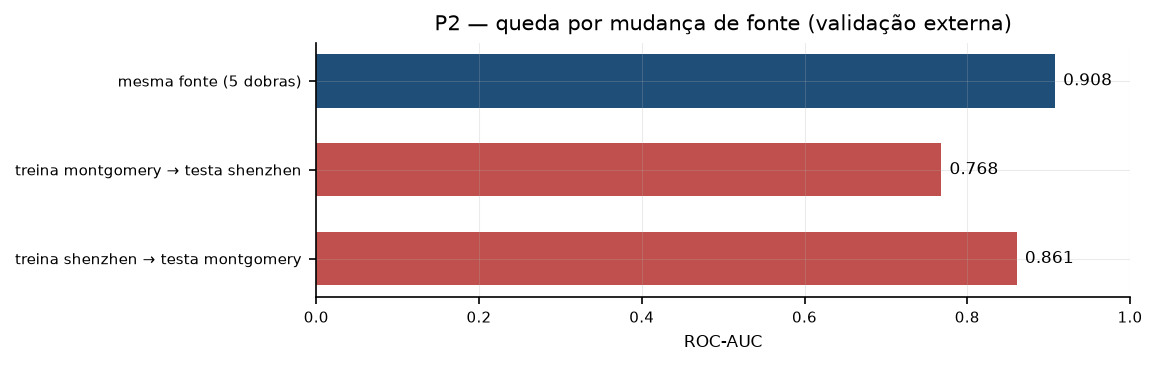
A validação externa da tuberculose revelou queda assimétrica (Tabela 3): treinar na fonte maior e testar na menor custa substancialmente menos do que o percurso inverso. A média dos dois sentidos é 0,8145, com queda média de -0,0934 em relação à avaliação intra-fonte. Reportar um único sentido produziria conclusões opostas conforme a escolha.
Tabela 3. Validação externa cruzada da tuberculose, nos dois sentidos.
| Condição | n (teste) | ROC-AUC | PR-AUC | Queda |
|---|---|---|---|---|
| Intra-fonte (5 dobras por paciente) | 800 | 0,9078 ± 0,0356 | 0,9124 ± 0,0347 | — |
| Treina montgomery → testa shenzhen | 662 | 0,7681 | 0,7543 | -0,1397 |
| Treina shenzhen → testa montgomery | 138 | 0,8608 | 0,8265 | -0,0470 |
| Média dos dois sentidos | — | 0,8145 | — | -0,0934 |
Duas verificações adicionais qualificam esse resultado. A primeira é desfavorável: um classificador que utiliza exclusivamente estatísticas brutas de imagem — brilho e dimensões — distingue as fontes com ROC-AUC 1,000 e prevê o próprio rótulo de tuberculose com 0,7599. Existe, portanto, sinal de aquisição disponível. A segunda é favorável e responde à primeira: o desempenho calculado dentro de cada fonte separadamente, sobre as predições fora da dobra, permanece elevado. Como a fonte é constante dentro de cada subconjunto, esses valores não podem ser atribuídos a sinal de aquisição.
Tabela 4. Desempenho intra-fonte, calculado separadamente por conjunto.
| Fonte | n | Taxa base | ROC-AUC |
|---|---|---|---|
| montgomery | 138 | 0,420 | 0,9304 |
| shenzhen | 662 | 0,508 | 0,9005 |
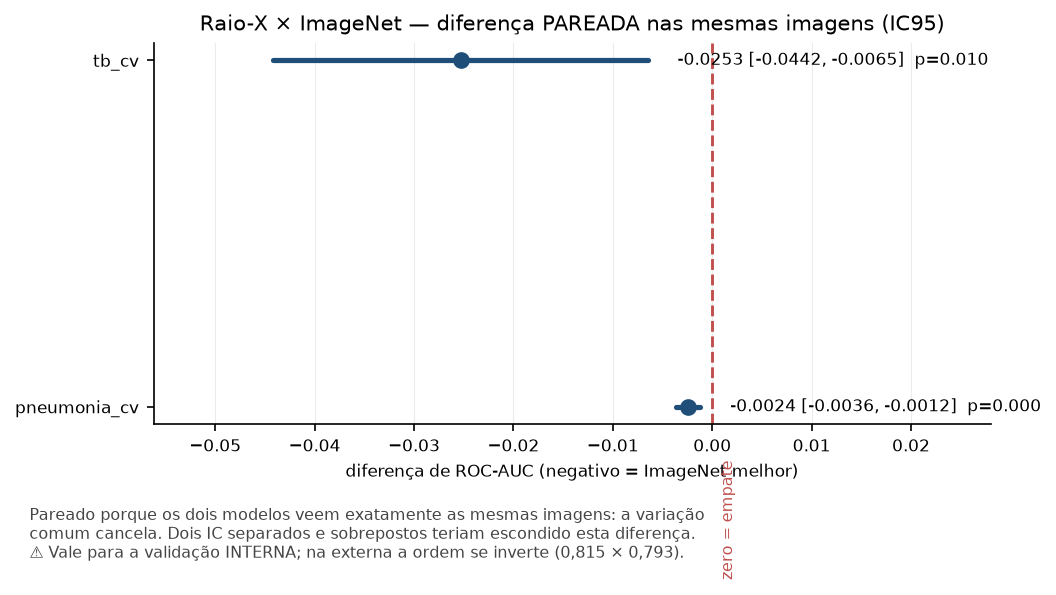
A comparação entre os dois pontos de partida inverte-se conforme a pergunta (Tabela 5). Na avaliação intra-fonte, a comparação pareada indica vantagem dos pesos de ImageNet, com intervalo de confiança que não contém zero. Na validação externa, a média favorece os pesos pré-treinados em radiografia. Não há resposta única para “qual pré-treino é melhor”: há duas respostas, para duas perguntas diferentes.
Tabela 5. Pontos de partida comparados, por tipo de avaliação.
| Avaliação | Pesos de raio-X | Pesos ImageNet | Quem vence |
|---|---|---|---|
| Intra-fonte (5 dobras) | 0,9078 ± 0,0356 | 0,9296 ± 0,0241 | ImageNet |
| Externa: treina montgomery → testa shenzhen | 0,7681 | 0,8057 | ImageNet |
| Externa: treina shenzhen → testa montgomery | 0,8608 | 0,7798 | raio-X |
| Externa (média) | 0,8145 | 0,7928 | raio-X |
3.3 P3 — discriminação aparente e utilidade limitada
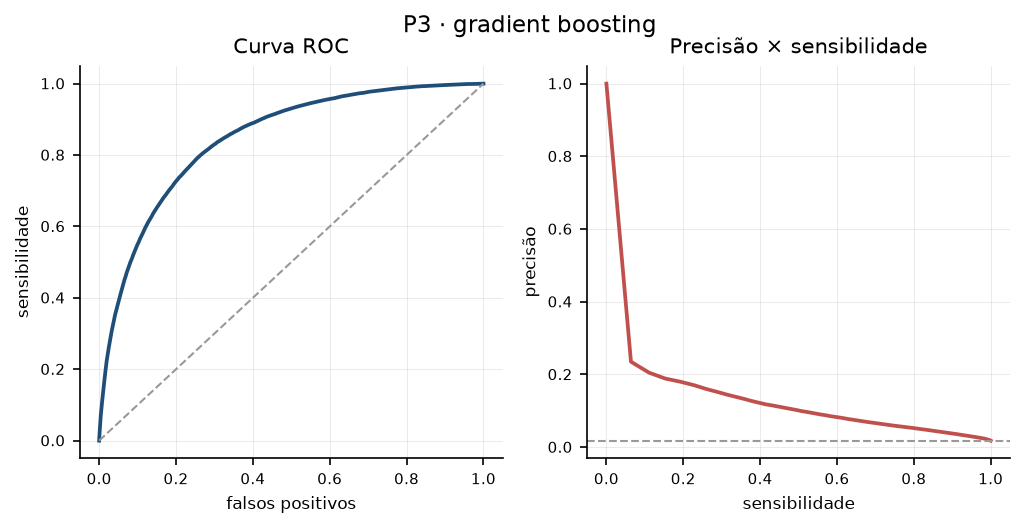
O modelo de gradient boosting atingiu ROC-AUC 0,8450 com PR-AUC 0,1137 (Tabela 6). A prevalência horária do desfecho é 1,80%, de modo que um classificador aleatório teria PR-AUC igual a essa proporção: o modelo situa-se aproximadamente 6,3 vezes acima do acaso — resultado real, porém muito distante do que a ROC-AUC sugere isoladamente. A rede recorrente, executada em unidade de processamento gráfico, ficou abaixo do baseline em ambas as métricas.
Tabela 6. Desempenho na predição de sepse.
| Modelo | ROC-AUC | PR-AUC | ECE |
|---|---|---|---|
| gradient boosting (CPU) | 0,8450 | 0,1137 | 0,0032 |
| LSTM temporal (GPU) | 0,7741 | 0,0829 | 0,1920 |
Na validação externa entre hospitais, o desempenho caiu para 0,7456 (hospital A → hospital B) e 0,7693 (hospital B → hospital A). A antecedência mediana do alerta foi de 38 horas; esse valor, entretanto, descreve apenas os pacientes alertados. Para 691 dos 2932 pacientes que desenvolveram sepse (23,6%), o modelo não emitiu alerta algum no limiar operacional adotado. Antecedência calculada sobre o subconjunto alertado é métrica incompleta quando reportada sem a cobertura.
3.4 Síntese
A Tabela 7 reúne, para cada projeto, o maior número obtido, o teste que o confrontou e o que restou depois dele.
Tabela 7. Síntese: o maior número, o teste de derrubada e o resultado.
| Projeto | Maior número | Teste de derrubada | Depois do teste | Veredito |
|---|---|---|---|---|
| P1 — moléculas | 17 candidatos nos 3 critérios | Composição da lista curta (classe química e similaridade ao treino) | 11 de 17 são classes antibióticas conhecidas; Tanimoto mediano 0,832 | Redescoberta, não descoberta |
| P2 — pneumonia | ROC-AUC 0,9946 ± 0,0023 | Oclusão do campo pulmonar | ROC-AUC 0,8305 apenas com a moldura | Atalho: número invalidado |
| P2 — tuberculose | ROC-AUC 0,9078 ± 0,0356 | Oclusão + validação externa nos dois sentidos + IC por paciente | Cai para 0,6566 sob oclusão; externa média 0,8145 | CONTROLE POSITIVO: sobrevive |
| P3 — sepse | ROC-AUC 0,8450 | PR-AUC contra a prevalência + externa entre hospitais + cobertura do alerta | PR-AUC 0,1137 (acaso 0,018); 691 de 2932 sem alerta | Modesto; o temporal perdeu do baseline |
Em nenhum dos três projetos o maior número foi o resultado mais confiável. A tuberculose, que apresenta número intermediário, é o único caso que atravessa todos os testes aplicados — e é por isso que funciona como controle positivo da bateria.
4. Discussão
Por que o número engana. Métricas de discriminação medem separabilidade no conjunto avaliado, não a validade do mecanismo que a produz. Quando existe variável correlacionada ao desfecho e mais fácil de aprender que o fenômeno — características de aquisição, prevalência distinta entre fontes, proximidade química ao conjunto de treino —, o modelo a utiliza. A métrica registra o sucesso; não registra a razão.
Validação externa de um só sentido também é selecionável. O achado de assimetria tem consequência prática direta: ao dispor de duas fontes, há duas validações externas possíveis, e a diferença entre elas foi, neste trabalho, da ordem de três vezes. Reportar apenas a mais favorável é uma forma de seleção que passa despercebida porque a validação externa já é vista como prática conservadora. Recomendamos reportar ambos os sentidos sempre que houver duas ou mais fontes.
Conclusões dependem da pergunta. A inversão observada entre pontos de partida ilustra que “melhor” não é propriedade do modelo, e sim da combinação entre modelo e regime de avaliação. Um trabalho que reportasse apenas a avaliação intra-fonte concluiria o oposto de um que reportasse apenas a externa, ambos corretos no que mediram.
A bateria é barata e portátil. Nenhum dos cinco procedimentos exigiu retreinamento; a oclusão reutiliza pesos já ajustados, os intervalos de confiança e a comparação pareada operam sobre predições já registradas, e a verificação de composição da lista é consulta a descritores. O custo é desprezível diante do treinamento que os precedeu. A condição prática é arquivar as predições brutas — identificador da unidade de observação, rótulo, probabilidade e fonte —, pois de métricas agregadas não se reconstrói incerteza.
O controle positivo é parte da contribuição. Uma bateria que reprovasse os três casos seria indistinguível de uma bateria mal calibrada. O caso da tuberculose demonstra que os procedimentos preservam resultado sustentado por sinal legítimo, e é o que autoriza interpretar as reprovações como informativas.
5. Limitações
- Equipe única, sem replicação independente das análises. Os testes foram concebidos e executados pelo mesmo autor que produziu os modelos.
- Conjuntos públicos e de tamanho modesto, notadamente uma das fontes de tuberculose com n reduzido, o que amplia a incerteza das estimativas por fonte.
- A bateria não é exaustiva: não contempla, por exemplo, análise de saliência, auditoria de subgrupos demográficos completos nem validação prospectiva.
- Ausência de validação in vitro para os candidatos moleculares e de validação prospectiva para os modelos clínicos. Nenhum resultado aqui autoriza uso clínico ou seleção de compostos para bancada.
- O terceiro critério do filtro molecular foi aplicado após inspeção dos resultados intermediários, ao constatar-se que não havia sido implementado na etapa original. A correção está relatada como tal, e o veredito só foi formulado depois dela.
- Três dos testes da bateria são pós-hoc, conforme declarado na seção 2.1.
6. Conclusão
Em três projetos independentes, de modalidades distintas, o maior número de desempenho e o resultado mais confiável não coincidiram. Uma bateria mínima de cinco testes de falsificação, executável em CPU e sem retreinamento, identificou um atalho que invalidava a alegação mais forte do conjunto, caracterizou como redescoberta uma lista de candidatos formalmente aprovada, dimensionou a utilidade real de um preditor clínico aparentemente competente e preservou um resultado legítimo.
Propomos que alegações de desempenho em aprendizado de máquina aplicado à saúde passem a incluir, como requisito mínimo: validação externa reportada em todos os sentidos disponíveis; ao menos um teste de ablação ou oclusão dirigido ao mecanismo; métricas sensíveis à prevalência quando o desfecho for raro; intervalos de confiança por reamostragem da unidade de observação; e publicação dos testes que falharam, com o mesmo destaque dos que confirmaram.
Referências
- Literatura sobre aprendizado de atalho em redes neurais profundas e suas manifestações em imagem médica.
- Estudos sobre identificação da instituição de origem a partir de radiografias e suas implicações para generalização.
- Revisões sobre vazamento de dados e reprodutibilidade em aprendizado de máquina aplicado à saúde.
- Trabalhos sobre domínio de aplicabilidade em modelagem quantitativa estrutura-atividade.
- Diretrizes de relato para modelos de predição clínica (TRIPOD e extensões para inteligência artificial).
- Metodologia de intervalos de confiança por reamostragem para métricas de discriminação com observações agrupadas.
- Discussão sobre PR-AUC e sua interpretação sob prevalência baixa.
- Descrições dos conjuntos públicos utilizados nas três modalidades.
storage/dados/portfolio/. Figuras: 7, todas reaproveitadas de /portfolio/figuras/. Nenhum número foi digitado manualmente.